Sommaire
Sans faire de bruit, l’intelligence artificielle a changé la façon dont les images sont comprises, triées et retrouvées, des photothèques d’entreprises aux plateformes sociales, en passant par les bases d’archives publiques. L’indexation visuelle, longtemps limitée à des mots-clés saisis à la main, bascule vers des systèmes capables de décrire, reconnaître et relier des contenus à grande échelle. Derrière ce basculement, des gains concrets en temps, en coûts, et en précision, mais aussi de nouvelles zones grises, juridiques et éthiques, qui s’invitent désormais dans les décisions des rédactions, des marques et des institutions.
Quand les machines « lisent » enfin les images
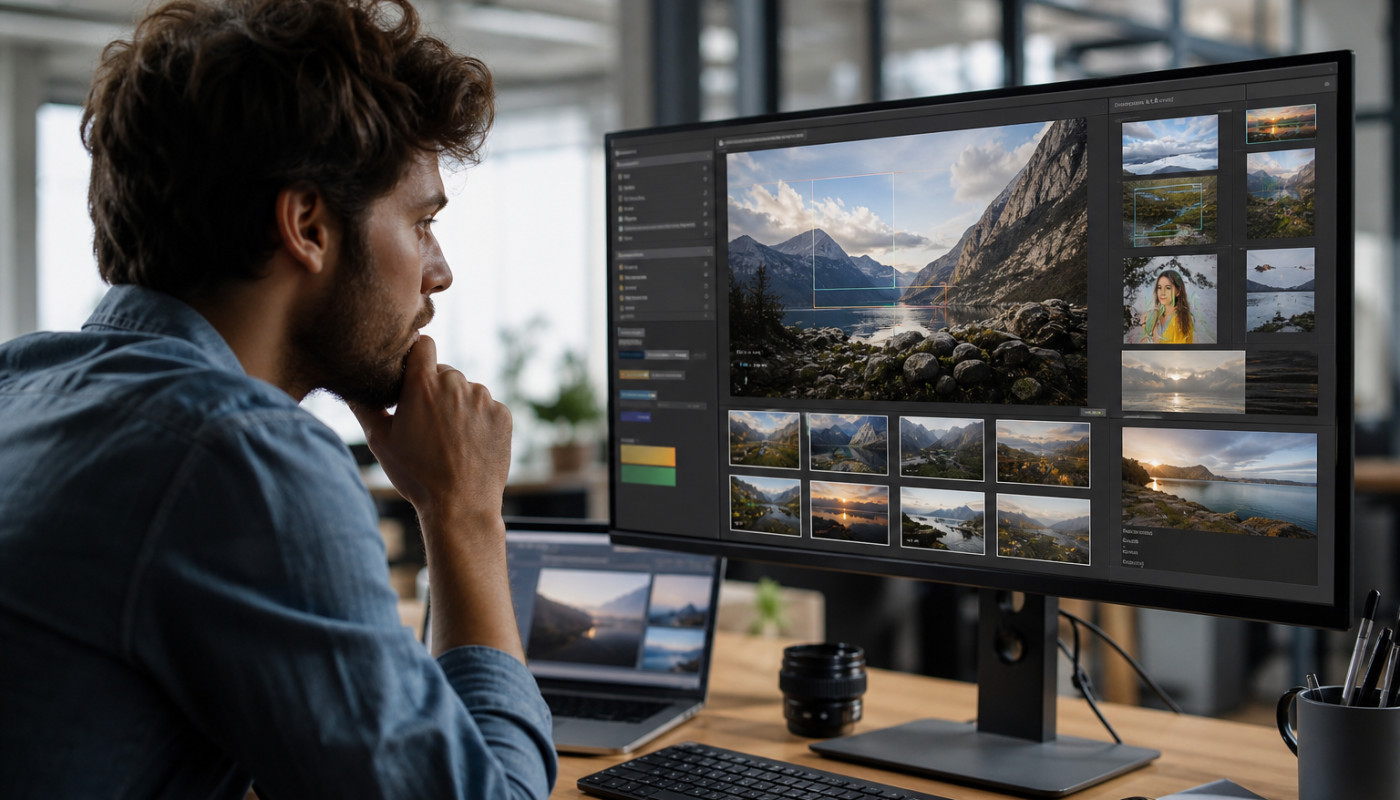
Le tournant ne tient pas à une promesse marketing, il tient à un fait technique : les modèles d’apprentissage profond ont appris à transformer des pixels en informations exploitables. Là où l’humain annotait une photo avec trois ou quatre mots-clés souvent subjectifs, les systèmes actuels produisent des descriptions plus riches, identifient des objets, des scènes, parfois des émotions, et surtout relient des images entre elles par similarité. Cette logique, dite « embedding », convertit une image en vecteur numérique, puis permet de la retrouver non plus seulement par texte, mais par proximité visuelle, un changement majeur pour les moteurs internes des entreprises comme pour les grandes plateformes.
Le marché s’appuie sur des briques devenues standards. Des familles de modèles comme ResNet, EfficientNet ou les Vision Transformers ont structuré la reconnaissance d’images, tandis que l’arrivée des modèles multimodaux, capables d’aligner texte et image, a accéléré la recherche « sémantique ». CLIP, publié par OpenAI en 2021, a notamment popularisé l’idée qu’une requête en langage naturel pouvait retrouver des images pertinentes sans étiquetage exhaustif. Les benchmarks ont suivi, de l’ImageNet historique aux jeux de données plus spécialisés, et les performances ont progressé, avec un effet immédiat : l’indexation visuelle n’est plus un projet expérimental, elle devient une fonction opérationnelle intégrée aux outils métiers.
Dans les organisations, l’impact est tangible et mesurable. Dans la gestion d’actifs numériques (DAM), l’annotation manuelle coûte cher, et elle vieillit mal, car un vocabulaire interne change, une campagne se termine, et les tags deviennent incohérents. Les moteurs d’indexation automatisée réduisent ce « bruit » en appliquant des règles homogènes, et ils offrent une redécouverte des contenus oubliés, un enjeu concret pour les médias et les services communication. Les plateformes de e-commerce, elles, combinent reconnaissance visuelle et recherche par similarité, un levier de conversion connu : quand l’utilisateur ne sait pas nommer un produit, il peut partir d’une image, et trouver « proche » plutôt que « exact ».
Des photothèques aux écrans : l’indexation partout
Un même geste, des usages multiples. L’indexation visuelle irrigue désormais des secteurs très différents, parce qu’elle répond à la même question : comment retrouver vite, dans une masse d’images, ce qui compte vraiment ? Dans la presse, l’enjeu se joue sur la vitesse de recherche dans les archives, sur la capacité à identifier des lieux, des personnalités ou des scènes, et sur l’enrichissement des métadonnées pour mieux exploiter un fonds iconographique. Les grandes agences d’images et de vidéos ont, depuis plusieurs années, renforcé leurs moteurs internes, car la volumétrie explose : la vidéo, qui n’était qu’un flux, devient elle aussi un objet indexé plan par plan, avec des repères temporels et des descriptions automatiques.
Dans la santé, l’indexation s’adosse à l’imagerie médicale, où l’IA sert à classer, prioriser, et parfois détecter des anomalies. Ici, l’enjeu n’est pas seulement de « taguer », il est de structurer des données visuelles pour améliorer le tri, accélérer la prise en charge, et faciliter la recherche clinique. Dans l’industrie, la vision par ordinateur indexe des défauts, des pièces, des étapes de production, et elle alimente la maintenance prédictive. En sécurité et dans l’espace public, la reconnaissance faciale et la détection d’événements posent des questions de libertés, mais elles illustrent une réalité : l’indexation visuelle ne se limite pas au marketing, elle touche des décisions sensibles.
Le commerce, enfin, en fait un outil de productivité. Les catalogues produits, autrefois construits à la main, s’enrichissent automatiquement : une IA propose des attributs, des catégories, des couleurs, et elle détecte des incohérences, par exemple une image qui ne correspond pas à la bonne fiche. Les réseaux sociaux, eux, s’appuient sur ces mécanismes pour recommander, modérer, ou contextualiser, en détectant des contenus sensibles, des marques, et des thèmes, avec des résultats inégaux selon les langues et les cultures. Car c’est là une limite structurante : l’indexation n’est jamais neutre, elle reflète les données d’entraînement, et donc les angles morts de la société.
La bataille de la précision, et ses angles morts
La promesse est séduisante, la réalité impose des garde-fous. Une IA d’indexation visuelle peut être très performante sur des objets courants, et beaucoup moins fiable sur des contextes rares, des scènes ambiguës, ou des signaux culturels. Une image de manifestation, par exemple, peut être classée de manière erronée selon les symboles visibles, et une tenue traditionnelle peut être mal interprétée si le modèle a été peu exposé à certaines régions du monde. Ce décalage n’est pas anecdotique : il conditionne la qualité des archives, la pertinence de la recherche, et parfois la réputation d’une organisation qui se retrouve avec des métadonnées problématiques.
La question des biais est documentée depuis plus d’une décennie dans la recherche, et elle a ressurgi avec force à mesure que les modèles se sont industrialisés. Des travaux académiques ont montré que les systèmes de reconnaissance pouvaient être moins précis selon la couleur de peau, le genre, ou l’âge, même si les performances se sont améliorées. Dans l’indexation, ces biais se traduisent par des erreurs de classification, des associations inappropriées, ou des omissions, qui peuvent invisibiliser des publics. Pour un média, une institution culturelle, ou une entreprise internationale, la qualité de l’indexation devient un enjeu de représentation, et donc un sujet éditorial autant que technique.
À cela s’ajoute un défi juridique, devenu central depuis l’adoption de l’AI Act européen en 2024, qui encadre les usages selon le niveau de risque, et impose des obligations de transparence, de documentation, et de gouvernance. Sans entrer dans la technicité du texte, le message est clair : plus l’IA touche à des domaines sensibles, plus le contrôle doit être robuste. Or l’indexation visuelle peut glisser rapidement vers des usages à risque, par exemple lorsqu’elle sert à identifier des personnes, à inférer des attributs sensibles, ou à alimenter des décisions automatisées. La conformité ne se résume plus à une case à cocher : elle oblige à cartographier les données, à contrôler les fournisseurs, et à documenter les limites du modèle.
Ce que les organisations mettent en place maintenant
Finie l’époque du « tout automatique ». Les meilleures pratiques qui se dessinent combinent IA, contrôle humain et règles de gouvernance, car l’indexation visuelle a un coût caché : celui des erreurs. Dans les organisations qui montent en maturité, la première étape consiste à définir un schéma de métadonnées clair, avec un vocabulaire contrôlé, des niveaux de confiance, et des catégories interdites, notamment lorsqu’elles touchent à des attributs sensibles. L’objectif est simple : éviter que l’IA invente des informations, et garantir qu’un moteur de recherche interne ne devienne pas une usine à contresens.
La deuxième étape, plus opérationnelle, est la mise en place d’un « human-in-the-loop » : l’IA propose, l’humain valide, corrige et enrichit, et ces corrections alimentent l’amélioration du système. Dans les photothèques de grande taille, on voit émerger des priorités, car tout revoir est impossible : on contrôle davantage les contenus à forte visibilité, les images utilisées en communication externe, et les fonds sensibles. On adopte aussi des métriques : taux d’erreur par catégorie, dérive des performances dans le temps, et comparaison entre modèles, parce que la qualité doit se piloter comme un produit.
Enfin, les organisations cherchent à comprendre l’écosystème, à suivre les avancées, et à identifier les acteurs qui structurent la diffusion de ces technologies, y compris sur les réseaux professionnels. Pour celles et ceux qui veulent suivre l’actualité du secteur, des retours d’expérience et des publications autour de l’IA appliquée, cliquez pour accéder. L’enjeu, au fond, n’est pas de céder à un effet de mode, il est de se doter d’outils qui rendent les images retrouvables, auditables et utiles, tout en assumant les limites inhérentes à l’automatisation.
Dernier point avant de se lancer
Avant d’investir, fixez un périmètre, un budget et un niveau de risque, puis testez sur un échantillon représentatif, afin de mesurer la précision, le coût de validation humaine, et la conformité. Pour les projets structurants, prévoyez un pilote de 6 à 12 semaines, et renseignez-vous sur les aides à la transformation numérique, souvent accessibles via les régions ou Bpifrance.
Sur le même sujet

Quand l'escalier devient le héros silencieux de votre intérieur

Tendances actuelles dans le design des boîtes cadeaux personnalisées

Maintenir la qualité de l'eau dans les systèmes de fontaines à eau modernes

Comment choisir la forme et la taille idéale d'une arche gonflable pour votre événement

Les tendances émergentes dans l'optimisation des affaires

Les tendances entrepreneuriales qui façonnent le futur

Le rôle des avocats en droit immobilier dans les transactions internationales

Portrait d'un notaire : quotidien et enjeux du métier

Le rôle d'un avocat immobilier dans le processus d'achat d'une propriété
